DataScience-Docker
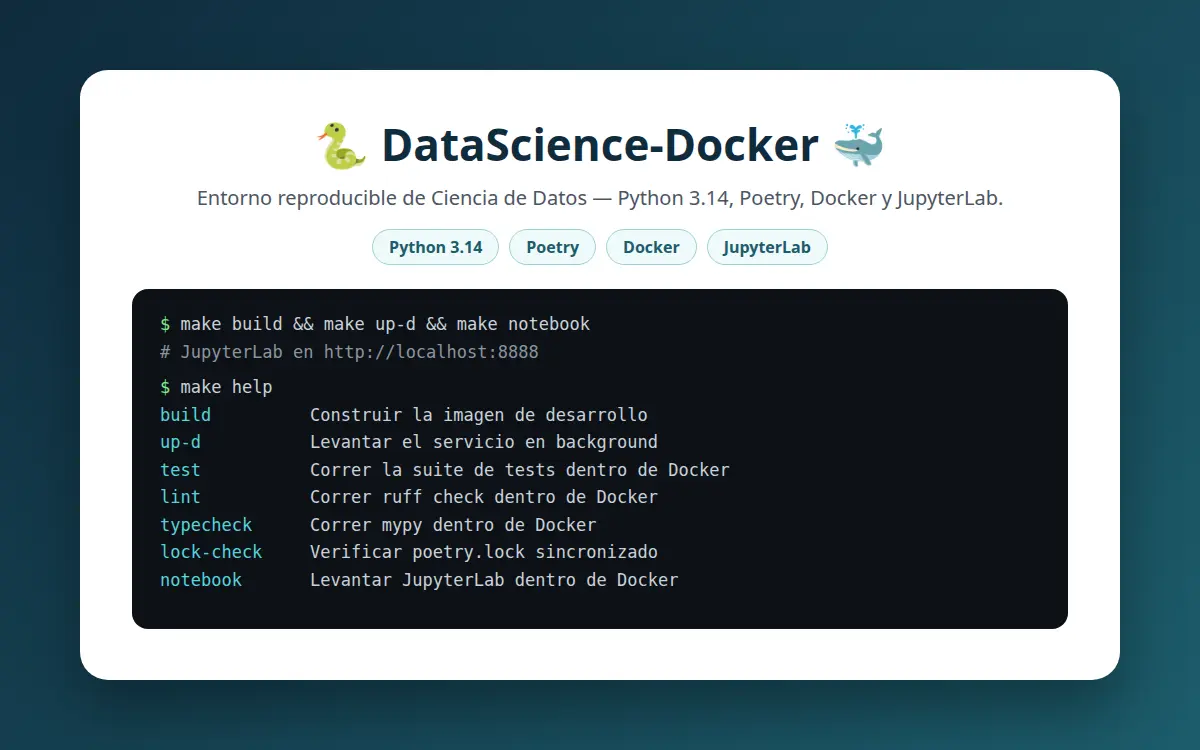
Entorno reproducible para Ciencia de Datos con Python 3.14, Poetry, Docker y JupyterLab: se levanta con un solo comando y corre igual en cualquier máquina.
Resumen del proyecto
DataScience-Docker es una plantilla de entorno de desarrollo para proyectos de Ciencia de Datos. Empaqueta Python 3.14, Poetry, pandas, scikit-learn y JupyterLab en un contenedor, para que abrir un notebook no dependa de instalar ni versionar nada en la máquina de cada persona.
Un Makefile concentra el flujo de trabajo (construir, levantar, abrir JupyterLab, correr pruebas, lint, formato y typecheck), y existe una vía local con Poetry como alternativa cuando no se quiere usar Docker.
Lo trato como un proyecto de software y no como un script suelto: pruebas con pytest, Ruff, mypy en modo estricto, un pipeline de CI con escaneo de seguridad y dependencias actualizadas de forma automática.
Características principales
- Contenedor de desarrollo con Python 3.14, Poetry, pandas, scikit-learn y JupyterLab
- Flujo de trabajo unificado con make: build, up-d, notebook, test, lint, format-check, typecheck y lock-check
- Vía local alternativa con Poetry cuando no se quiere usar Docker
- Hook de pre-commit que corre lint y verificación de formato dentro del contenedor
- Guía para usar los notebooks desde VS Code conectado al servidor de Jupyter del contenedor
Stack
Problema
Los entornos de Ciencia de Datos suelen armarse a mano y se rompen entre máquinas: versiones de Python distintas, dependencias sin fijar y notebooks que funcionan solo en la laptop de quien los escribió.
Enfoque
Se definió un solo contenedor de desarrollo con las dependencias fijadas en poetry.lock y se puso todo el flujo detrás de comandos make, de modo que local y CI ejecutan exactamente lo mismo dentro de Docker. La calidad se exige con puertas automáticas: lint, formato, typecheck, verificación del lockfile y escaneo con Trivy.
Resultados
- Entorno completo levantado con make build, make up-d y make notebook, sin instalar Python ni dependencias en el host
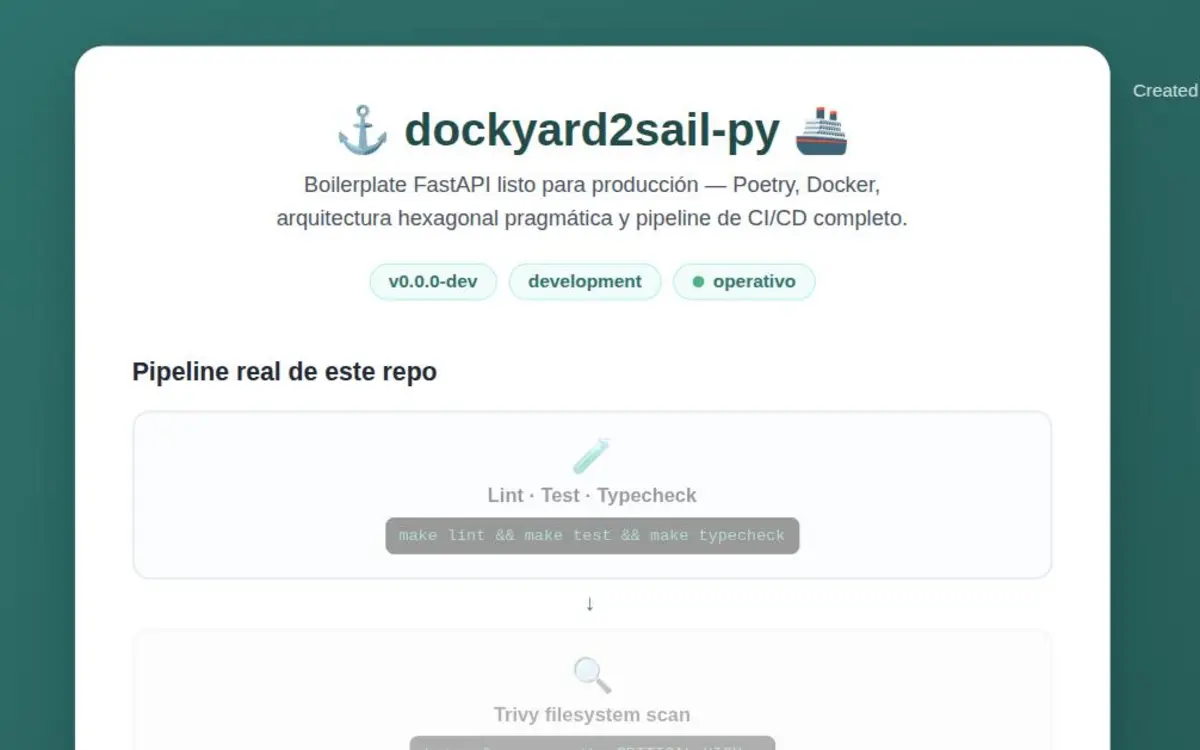
- CI con seis trabajos (pruebas con cobertura mínima de 80%, Ruff, formato, mypy estricto, verificación del lockfile y Trivy), con las acciones fijadas por commit SHA y permisos mínimos
- Dependabot semanal para dependencias de pip y GitHub Actions, con la versión 1.0.0 publicada
Cliente
Proyecto personal
Cronología
Abril 2024 - Presente
Rol
Data Scientist & Desarrollador
© 2026 Cuauhtémoc Bautista